ZENGSU INTELLIGENCE
增速智谈·科普系列
具身智能基础技术|VLA 01
“把快要掉下桌的袋子捡起来。”
传统机器人很难处理这类指令。它没有给出袋子的坐标,也没有规定机械臂该沿哪条轨迹运动。“快要掉下去”描述的是人对眼前局势的判断。
Google DeepMind 在 2023 年用 RT-2 演示过这个任务。模型先从图像里认出哪个袋子处在桌边,再把语言目标变成一串动作:机械臂往哪个方向移动、末端怎样旋转、夹爪何时闭合。研究团队把这类模型叫作 Vision-Language-Action model,视觉—语言—动作模型,也就是后来被频繁提起的 VLA。
工业机械臂早已能更快、更准地捡起袋子。RT-2 的技术价值在于把视觉识别、语言理解和动作策略放进一条可共同训练的链路。机器人由此可以利用图像和语言知识,判断“该对哪个东西做什么”,再生成相应动作。
但从“看懂快掉下去的袋子”到“稳稳把它抓住”,中间还隔着机器人最难的最后一厘米。物体会滑,镜头有延迟,手臂有误差,夹爪碰到袋子后,下一步观察已经和模型原先预想的不一样。语言模型说错一句话,最多需要重写;机器人动错一步,可能把东西碰落、撞到人,或者让后面几十步全部失去意义。
VLA 把视觉语义、语言目标和可执行动作接进同一个学习接口。机器人开发因此开始从“每个任务单独写一套策略”,转向“预训练动作底座,再用较少数据适配任务和身体”。实时控制、接触反馈、长程记忆、失败恢复和安全仍由完整系统共同承担。
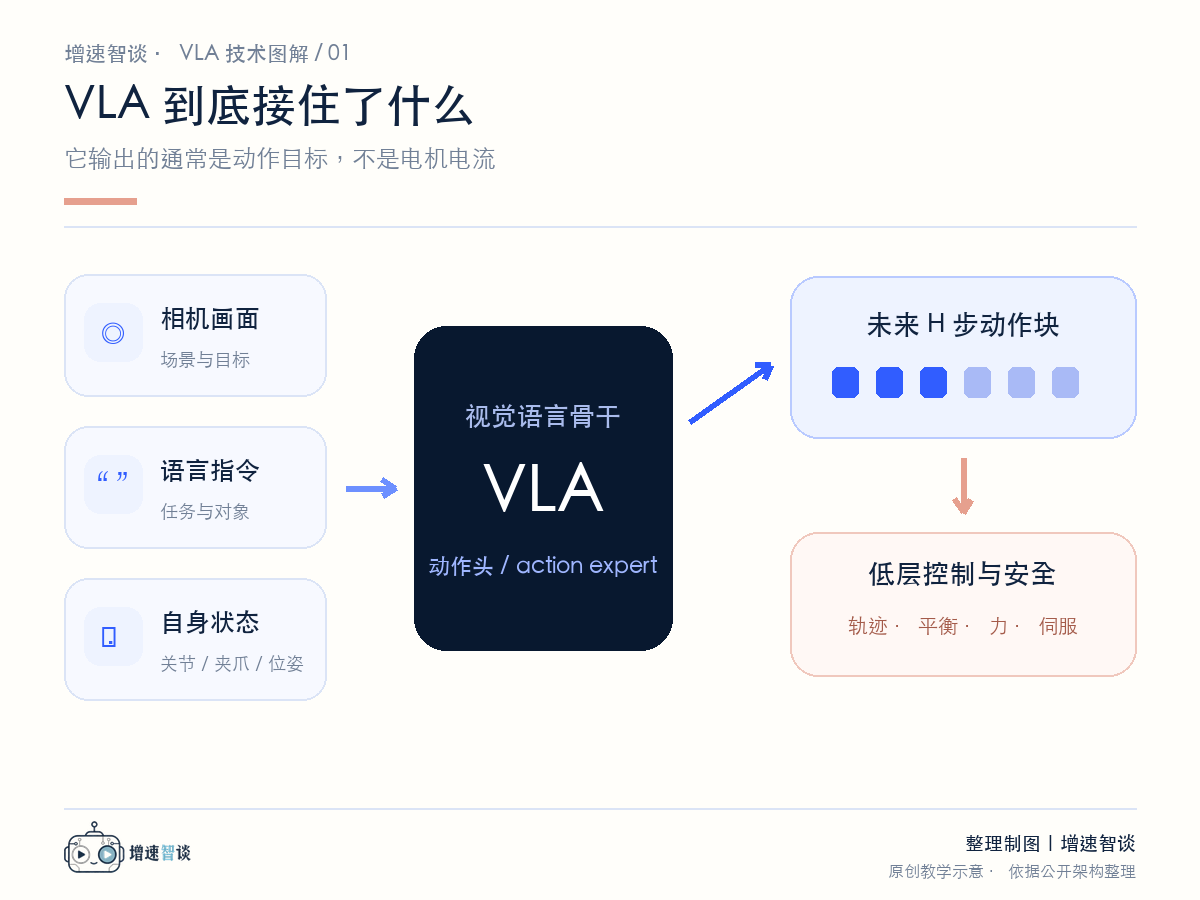
一套常见的 VLA,在时刻 t 会接收三类信息:摄像头图像、语言目标和机器人自身状态,例如关节位置、夹爪开合和末端位姿。模型随后给出机器人接下来要执行的一步或一小段动作。
用一个极简写法表示,就是:
未来动作 = VLA(当前画面,语言目标,机器人状态)
动作具体是什么,差别很大。
对桌面机械臂,它可能是末端向前、向左、向上各移动多少,旋转多少,夹爪打开还是闭合。对双臂机器人,它要同时安排左右手。对人形机器人,它还可能覆盖腰、腿、手臂和手指。也有模型直接输出各个关节的目标位置。
理解 VLA 需要先明确一点:“A”没有统一格式。相同的“把杯子放进水槽”,在轮式双臂、固定机械臂和人形机器人上,会变成长度不同、物理意义不同的动作向量。摄像头位置、关节数和控制方式一变,模型与身体之间的接口也会改变。
VLA 输出的动作通常还要交给下一层。轨迹控制器、全身控制器和电机伺服会以更高频率处理动力学、平衡、碰撞和力。这里的“端到端”主要指感知到动作可以联合学习,控制链仍会继续延伸到高频控制器和电机伺服。
VLA 把“看见什么、要做什么”转成动作目标;高频控制与安全继续由下一层系统承担。
增速智谈原创教学示意|依据 RT-2、OpenVLA、π0、GR00T 公开架构整理。
VLA 最早的一条直观路线,是把动作也变成 token。
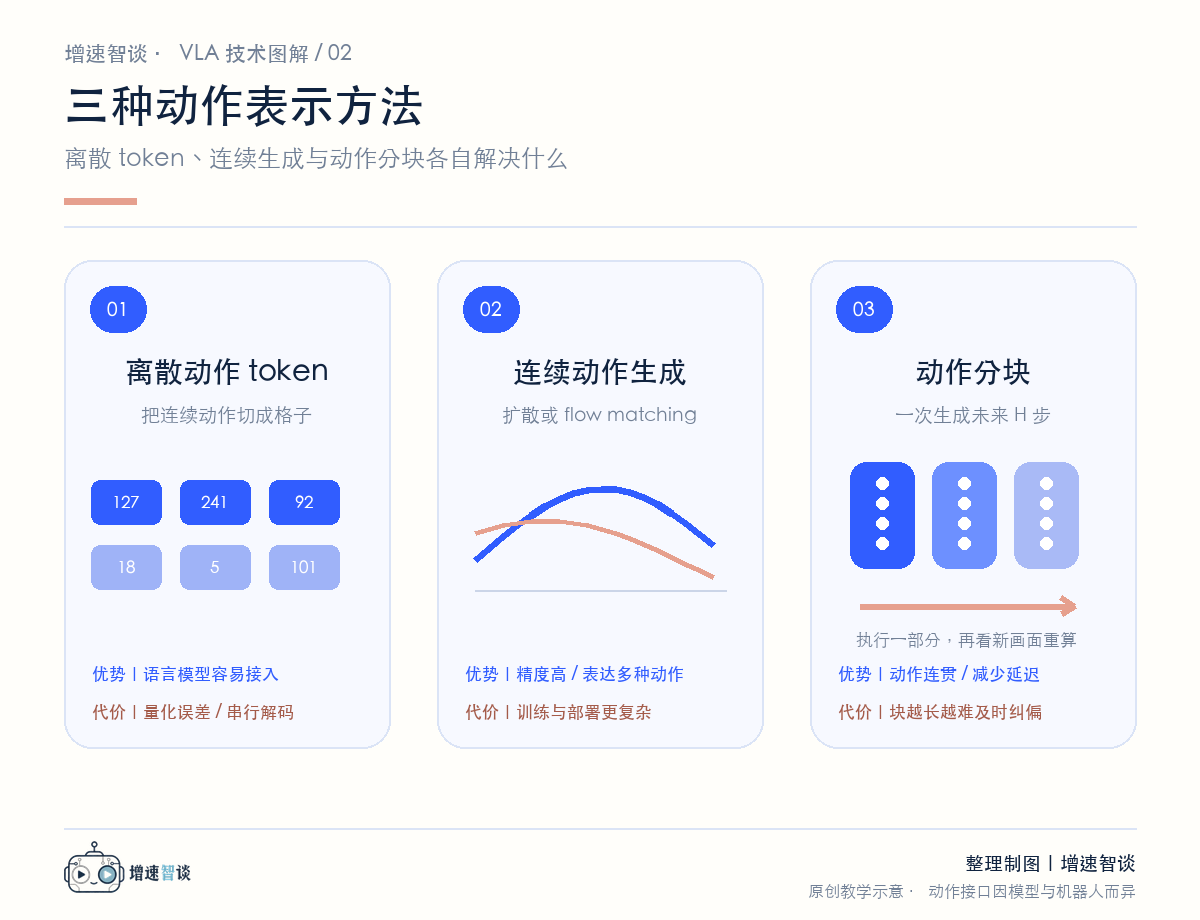
RT-2 沿用了 RT-1 的离散动作,把连续的位移、旋转和夹爪状态切成一个个区间,再写成语言模型能够处理的字符串。这样一来,已经具备图像和语言能力的模型可以沿用原有输出框架,在训练中同时学习网页图文与机器人动作。
这条路线表明,互联网上学到的“草莓是什么”“哪个袋子快掉下去了”“什么东西可以临时当锤子”,可以迁移到机器人任务里。RT-2 在自己的未见场景测试中,把成功率从 RT-1 的 32% 提高到 62%。这组结果说明,视觉语言预训练能够补充机器人数据中昂贵又稀缺的语义知识;它仍然受具体机器人、任务和评测设置约束。
机器人动作对时间、精度和连续性更加敏感。
一句话晚半秒出现,读者通常察觉不到;机械臂每一步都晚半秒,轨迹会变得断断续续。把连续动作切成离散格子,还会带来精度损失。逐个生成动作 token,也很难满足需要快速反馈的任务。RT-1 的实机闭环频率是 3 Hz,每秒做三次高层动作决定,适合它的移动操作任务;高速接触和动态平衡仍需要更快的控制回路。
后来越来越多模型让语义理解与动作生成分工。π0 在视觉语言骨干之外增加动作专家(action expert),用流匹配(flow matching)生成连续动作;Octo 和 GR00T 等路线使用扩散式动作生成;OpenVLA-OFT 则结合连续动作、并行解码和动作分块(action chunking)。
动作分块让模型一次生成未来一小段动作。机器人先执行其中一部分,再根据新画面滚动重算。人伸手拿杯子时也会先形成一段连贯动作,并根据视觉和接触变化中途纠正。
动作分块解决了两个问题:一是减少大模型反复推理带来的延迟,二是让动作在短时间内更连贯。代价也很清楚:块越长,运行越顺,却越可能在环境变化后继续执行一段已经过时的计划;块越短,反馈更及时,但计算压力又回来。
OpenVLA-OFT 的作者在指定评测中报告,相比基础版 OpenVLA,其方法让动作生成提速 25—50 倍,并提高了任务成功率。这组结果只适用于论文给定的机器人和任务,但它突出了实机部署的一项关键指标:动作策略既要生成正确动作,也要在控制周期内完成计算。
动作策略需要同时满足三个条件:动作准确、生成及时、反馈可用。
增速智谈原创教学示意|动作接口因模型与机器人而异。
大语言模型可以从互联网吸收万亿级 token,机器人没有这样的现成语料。
RT-1 为约 13 万段真实轨迹动用了 13 台机器人,连续采集 17 个月,覆盖 700 多项任务。
到 2023 年,Open X-Embodiment 汇集 34 个实验室的 60 个数据集,形成超过 100 万段真实轨迹、覆盖 22 种机器人本体的数据池。OpenVLA 从中整理约 97 万段轨迹,训练出一个 70 亿参数的开源 VLA。
百万级轨迹与网页数据的规模仍相差很远,轨迹之间也存在明显差异。不同实验室使用不同的相机、控制频率和机械臂,对“动作”的定义也不统一:有的记录末端位姿,有的记录关节目标;有的配有腕部相机,有的只有外部视角;任务语言有时精细,有时只是模糊标签。
Open X-Embodiment 和 RT-X 尝试把不同机器人的动作投到相对夹爪坐标系下,用统一的七维向量表示位移、旋转和夹爪开合。Octo 进一步接收不同的相机与本体状态,并允许下游更换动作空间。共享预训练由此提供了一个见过多种任务的策略起点,换身体后仍需继续适配。
现有训练数据大致沿三条互补路线扩展。
一条追求异构性。Open X-Embodiment 让模型见到更多身体、环境和任务,希望不同机器人的经验可以相互迁移。另一条追求一致性和质量。AgiBot World 的论文披露,它用 100 多台同构机器人采集约 100 万段轨迹、2976.4 小时数据,覆盖 217 个具体任务、87 项技能和 106 个场景。只用人工审核通过的数据训练时,任务完成度分数从 0.41 提高到 0.59。这组实验体现了数据质量对结果的直接影响。
第三条路线使用合成数据。GraspVLA 在仿真中生成约 1000 万条抓取轨迹、10 亿帧画面,用纯合成动作数据预训练,再迁移到真实抓取。几何主导、动作边界清楚的任务可以借此迅速扩大数据规模;插拔、系结、擦拭等接触更复杂的任务仍需单独验证。
三类数据承担不同作用:
• 网页图文提供物体、概念和常识,但没有真实机器人动作;
• 真机示范提供动作与后果的对应关系,但昂贵、分布窄;
• 仿真提供规模、可控变量和失败样本,但必须跨过现实差距。
训练的关键在于识别共享边界:哪些知识可以跨机器人复用,哪些动作只对某具身体有效,哪些视觉差异只改变外观,哪些细微变化会直接改变接触结果。
数据规模扩大任务覆盖面,数据对齐决定不同机器人之间能共享多少经验。
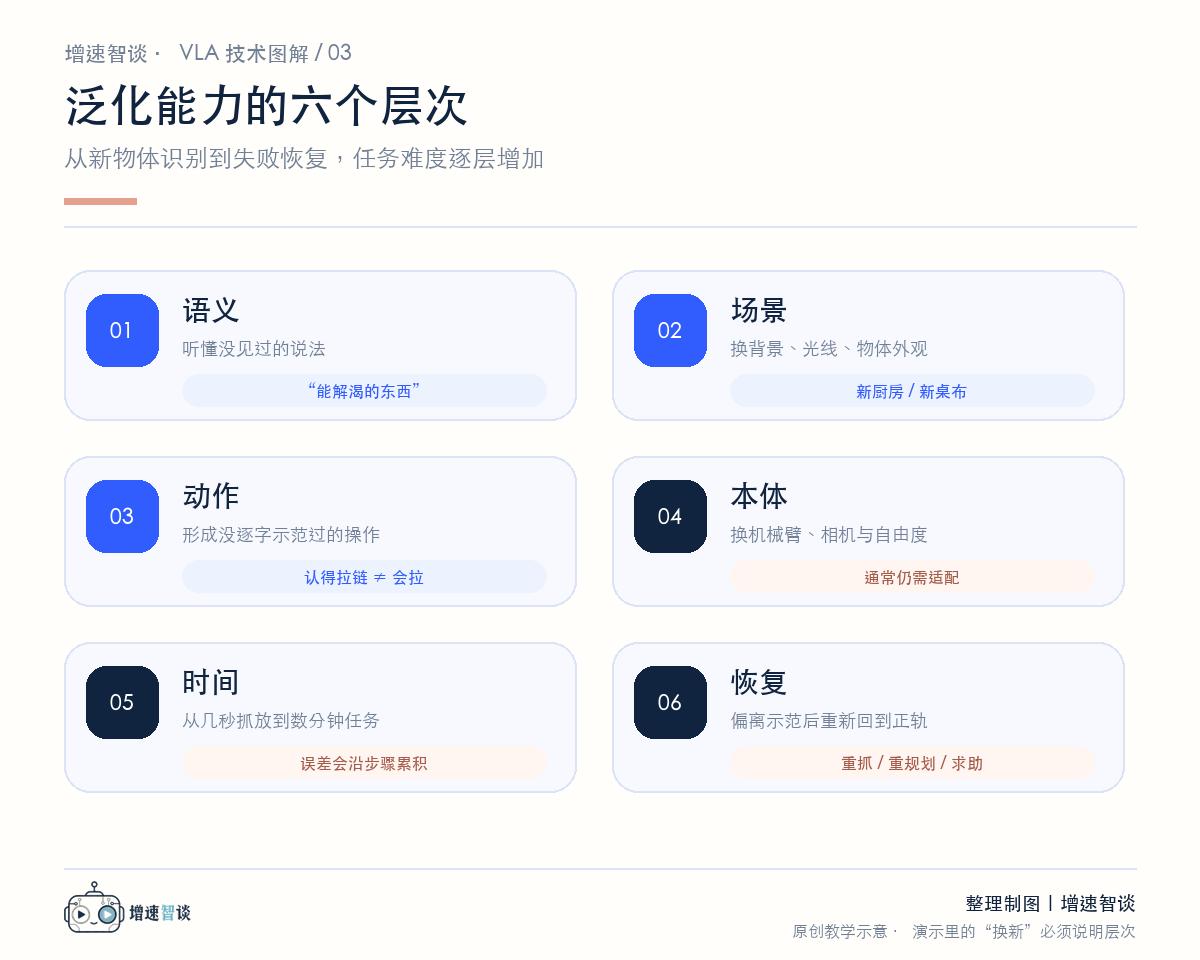
讨论 VLA 的“泛化”时,需要先说明测试究竟换了什么。新杯子、新房间和新机器人对应不同层次,技术难度相差很大。
第一层是语义泛化。机器人没见过“能解渴的东西”这句指令,但能借助视觉语言知识选中水。这是 VLM 最容易带给 VLA 的能力。
第二层是视觉和场景泛化。桌布、光线、背景和物体外观变了,机器人仍能找到目标。RT-2 的未见场景结果主要证明的是这一类迁移。
第三层是动作泛化。模型认出新物体后,还要形成训练中没有逐字出现过的操作方式。识别拉链和灯泡只提供语义前提,真正操作仍需要合适的轨迹、力度和接触时机。
第四层是跨本体。把在 Franka 机械臂上学到的经验迁移到双臂或人形机器人。动作维度、相机视角、可达空间和动力学都变了,通常需要新的示范与后训练。Gemini Robotics On-Device 2 官方称,用少于 200 个样本、数小时数据即可适配新的双臂本体。这项结果体现的是适配成本下降,部署过程仍包含新数据和后训练。
第五层是时间泛化。从几秒钟的抓放,走向数分钟、多房间、多步骤任务。动作越长,任何一步的小误差都可能改变后续状态。π0.5 的论文展示了在训练集之外的新住宅完成 10—15 分钟整理任务;Gemini Robotics ER 2 把任务跟踪扩展到数分钟和数百次决定。这些结果推动了长程任务能力,全天候可靠性仍需更长期测试。
第六层是失败恢复。抓偏了能不能再抓,抽屉没拉开能不能改变策略,找不到目标时会不会求助。只用成功示范做行为克隆的模型,最容易在这里暴露短板:一旦偏离示范走过的状态,错误会层层累积。
2025 年发布的 REALM 基准专门用 15 类扰动、7 种操作技能和 3500 多个物体测试 VLA。作者对 π0、π0-FAST 和 GR00T N1.5 的评估结论仍然克制:泛化与鲁棒性是开放问题。它提醒我们,漂亮演示往往展示“能做到什么”,系统评测才开始回答“换一点条件后,还剩多少”。
增速智谈原创教学示意|演示里的“换新”必须说明究竟换了哪一层。
如果大模型足够强,能不能把看、想、走、抓全部塞进同一个网络?
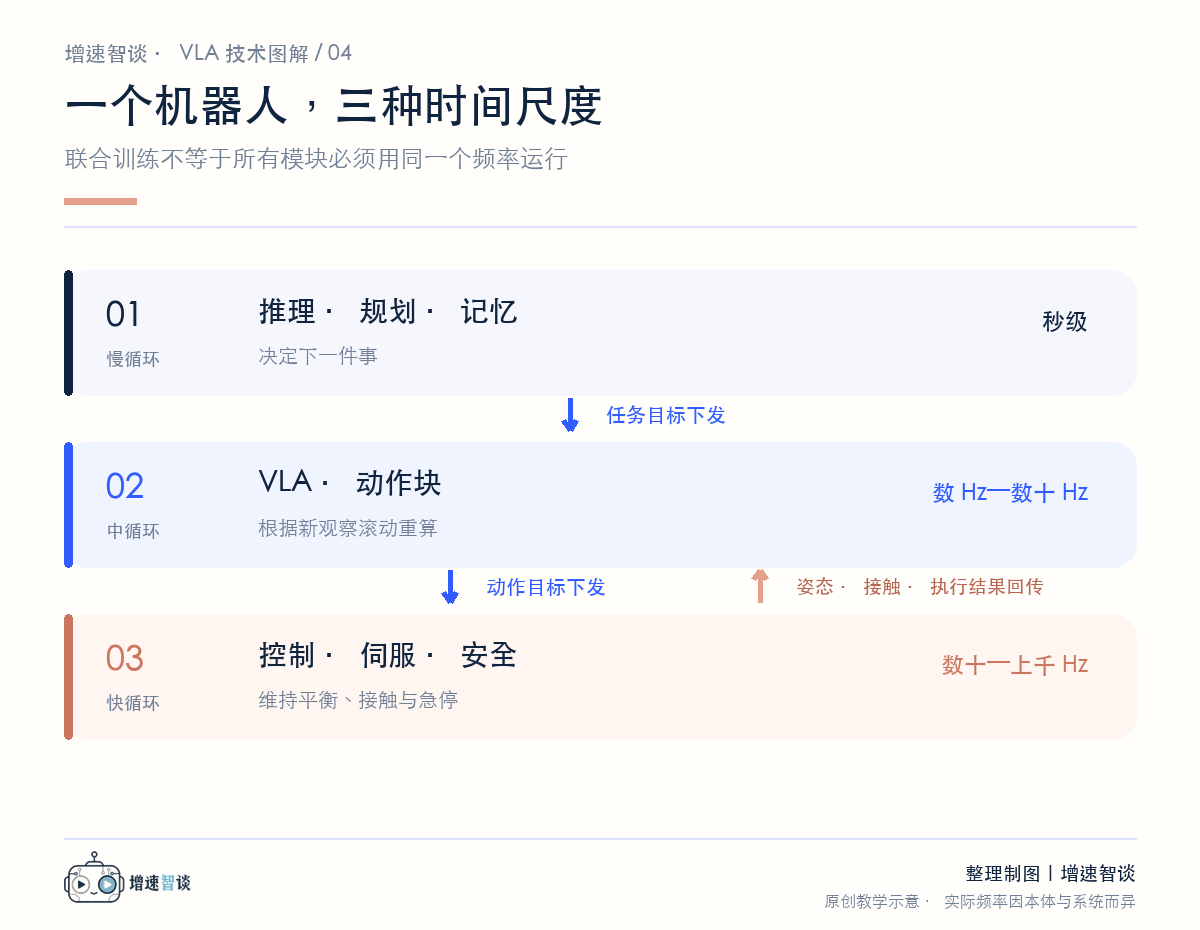
当前前沿系统普遍选择联合训练、分层运行。
π0.5 在预训练阶段把动作离散成 token,以便和图文、目标检测、高层子任务等异构数据共同训练;后训练阶段再加入连续动作 action expert。推理时,模型先产生一个语义子任务,再让动作专家生成低层动作。
Gemini Robotics 2 的公开系统把分工写得更清楚。Gemini Robotics ER 2 负责与人沟通、理解场景、拆解多步任务、跟踪进度;VLA 负责把当前目标变成机器人动作;低层控制系统继续管理身体稳定和物理安全。NVIDIA 在 GR00T N1.6 之外,也在公开研究中加入高层规划与记忆模块,去补动作模型缺少长期记忆的问题。
这种分工来自机器人任务天然存在的不同时间尺度:
• 规划和记忆可能几秒更新一次,决定接下来做哪件事;
• VLA 以更快频率观察环境,生成一小段动作;
• 全身控制、碰撞检测和电机伺服需要几十到上千赫兹地维持稳定与安全。
三层可以共享训练目标和信息,但各自仍需适合自身任务的模型、表示与运行频率。
联合训练负责共享知识,分层运行负责匹配物理世界的不同时间尺度。
增速智谈原创教学示意|实际频率因本体与系统设计而异。
VLA 已经把机器人的能力上限往前推了一大步,但部署中的麻烦往往藏在演示视频之外。
动作误差会积累。GR00T N1.6 团队报告,相对动作通常更平滑、更准确,但在小数据任务上容易积累误差,削弱纠正能力。单次 2 毫米偏差很小;连续几十步都以偏差后的状态为起点,最终结果就会改变。
视觉缺少接触细节。只看 RGB 图像,模型很难精确知道夹持力、摩擦、物体是否已经卡住。力觉、触觉和机器人自身状态可以补充信息,数据采集、传感器校准和跨平台统一也会随之变得更难。
系统还要判断何时停止。模型需要识别任务是否完成、能力是否足够,以及何时请求人类接管。Google DeepMind 在 ASIMOV-Agentic 中专门测试智能体能否拒绝违反约束的任务、在硬件故障或人类靠近时触发保护、屏蔽超出 VLA 分布的动作,并在指令模糊时主动求助。这类评测把动作成功率和系统安全分开衡量。
安全需要独立控制回路。Gemini Robotics 的官方安全说明仍然保留传统机器人措施:碰撞避免、接触力限制、动态稳定性和安全停机。语言模型可以理解“不要把热锅递给孩子”;电机超速和身体失衡则由确定性的监控与控制回路处理。
短期内,VLA 更适合被理解为一层逐渐通用的动作能力:向上连接自然语言、视觉常识和任务规划,向下连接不同身体、控制器和安全机制。它的产业价值将体现为更少的新增任务数据、更短的本体适配周期,以及更低的技能开发工程量。
模型名字会继续变化,但判断框架可以稳定下来。
第一,使用的是什么机器人、哪些传感器?同一任务在固定机械臂、轮式双臂和人形机器人上的难度不同;是否有腕部相机、力觉和触觉,也会改变结果。
第二,模型实际输出什么动作?需要区分末端位姿、关节目标和全身动作,并说明上层 VLA 与底层控制各自负责什么。
第三,控制频率、动作块长度和延迟是多少?实时闭环需要结合原始运行速度与延迟数据判断,剪辑后的流畅画面无法提供这些信息。
第四,测试到底换了什么?换杯子、换房间、换动作、换身体、换任务时长,代表六种不同的泛化。
第五,上新机器人或新任务用了多少数据和后训练?“基础模型”通常提供更好的初始化,新本体和新任务依然需要适配成本。
第六,成功率的分母是什么?试验次数、初始状态、失败定义、是否允许复位或人工接管,都应与最佳演示一起披露。
第七,失败后怎样恢复,安全由谁兜底?长期运行还要统计失败发现、恢复策略、人工接管和安全停机。
这七个问题对应着 VLA 接下来更有价值的指标:新任务所需数据量、换身体的适配时间、长任务中的人工接管率、失败发现与恢复能力,以及安全边界的可验证性。
从 RT-1、RT-2 到 OpenVLA、π0.5、GR00T 和 Gemini Robotics 2,VLA 的能力沿着一条连续路线扩展:更多任务进入同一个策略,视觉语言知识帮助模型理解新物体和新指令,连续动作与动作分块改善执行,跨本体和长任务继续扩大适用范围。记忆、失败恢复与安全则把动作能力接入完整机器人系统。
越接近真实部署,系统分工越需要清楚:可从大数据中学习的部分交给模型,高频稳定性由控制器保证,安全边界由独立机制约束,超出能力的情况交给人处理。
VLA 正在把“看懂以后怎样动手”变成可规模化预训练的能力。下一阶段的差距将落在更具体的指标上:新任务需要多少数据,换一具身体要适配多久,长任务需要多少次人工接管,以及安全边界能否被验证。
资料来源
- RT-1: Robotics Transformer
- RT-2: New model translates vision and language into action
- Open X-Embodiment: Robotic Learning Datasets and RT-X Models
- Octo: An Open-Source Generalist Robot Policy
- OpenVLA: An Open-Source Vision-Language-Action Model
- OpenVLA-OFT: Fine-Tuning Vision-Language-Action Models
- π0: A Vision-Language-Action Flow Model for General Robot Control
- π0.5: a VLA Model with Open-World Generalization
- GR00T N1.6
- Gemini Robotics 2 brings whole body intelligence to robots
- AgiBot World Colosseo / GO-1
- GraspVLA: a Grasping Foundation Model Pre-trained on Billion-scale Synthetic Action Data
- REALM: A Real-to-Sim Validated Benchmark for Generalization in Robotic Manipulation
- ASIMOV-Agentic-v1
- Introducing Gemini Robotics and Gemini Robotics-ER
- Vesta