ZENGSU INTELLIGENCE
增速智谈·科普系列
AI 决策模型技术篇 01
一封客户邮件进来,系统真正需要的也许不是一段漂亮回复,而只是三个判断:它属于退款、物流还是账户问题?风险高不高?要不要交给人?Jev 把这类“小判断”从大语言模型里单独拆了出来。它可能不是一种从零开始的新技术,却准确击中了 Agent 时代最昂贵、也最容易被忽略的一层。
2026 年 9 月,一个不会写文章、不会聊天、甚至不能输出一句完整解释的 AI 模型,突然成了开发者社区的热门话题。
它叫 Jev,由旧金山创业公司 TypeSafe AI 发布。官方把它称作第一个 “System One Model”:给模型一段状态,再给它若干封闭问题,它不生成文本,只返回选择、分数、真假概率和置信度。TypeSafe 给它的口号是 “Decisions, not strings”——要决定,不要字符串。[1][2]
这套说法很容易让人产生两种相反的误读。一种把它视为“反 LLM 革命”,仿佛生成式 AI 将被判断式 AI 取代;另一种则认为它无非是一个重新包装的分类器,没有任何新意。
两种判断都漏掉了真正值得看的变化。
Jev 的关键不在于它会不会分类,而在于它把自然语言理解、开放标签、概率输出、并行判断和软件类型接口压缩成了一次模型调用。它不是为了回答人,而是为了让程序在毫秒级做出下一步动作。
这篇文章试图回答四个问题:Jev 到底怎样工作;它与分类器、NLI、结构化输出 LLM 有什么关系;最近一周涌现的论文究竟证明了什么;以及企业如果真想把它放进 Agent 或自动化系统,应该怎样判断它是否值得用。
01
Jev 做的事,其实是一条“模糊的 if 语句”
传统代码擅长精确规则:金额大于 10 万元就进入复核,库存为零就停止下单,用户没有权限就拒绝操作。
真正难写的是另一类规则:这封邮件是不是在隐晦地投诉?这段检索结果是否真的支持回答?当前页面上哪个按钮最符合下一步目标?某次工具调用看起来是否危险?
这些问题都有有限答案,却很难用固定关键词或手写规则覆盖。过去两年,很多团队直接调用一个通用 LLM,让它输出 JSON,再从 JSON 里取出一个标签。能力够强,但代价也明显:模型要逐 token 生成,必须约束格式、处理解析失败,还要为一段最终只剩 true 或 billing 的答案支付整次推理成本。
Jev 试图把这一层直接做成模型接口。
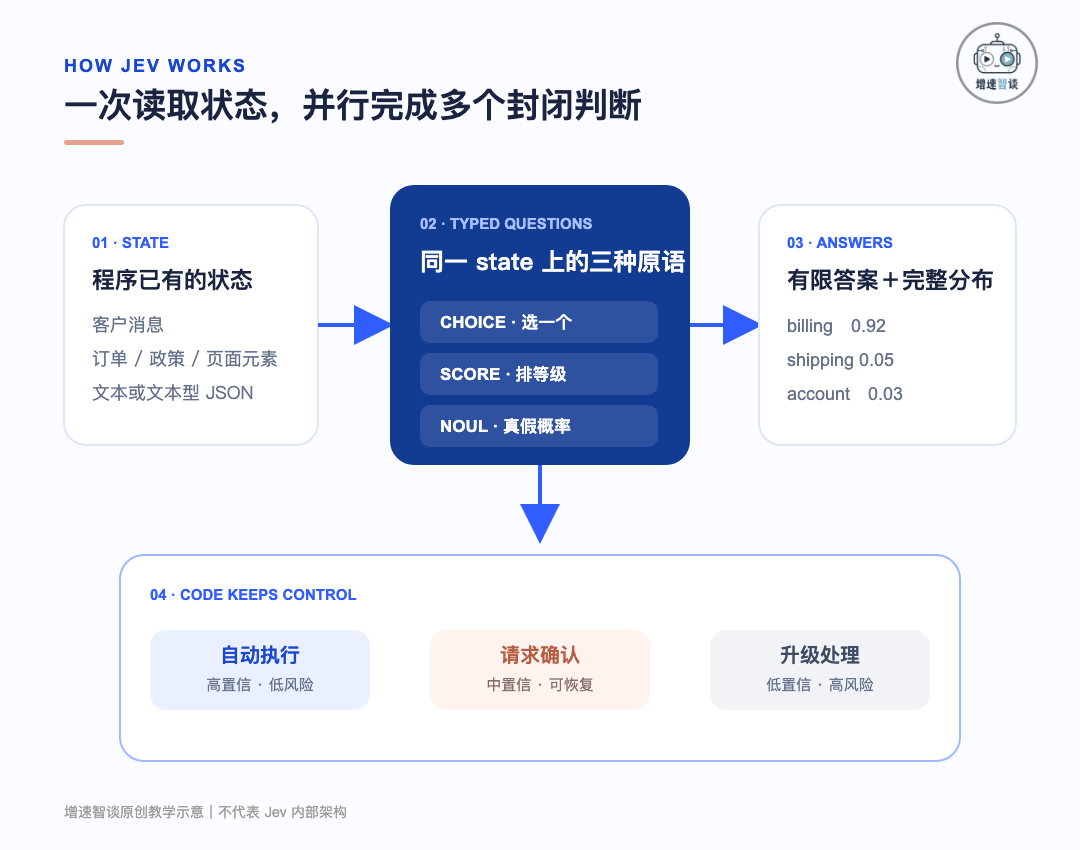
图 1:Jev 读取共享 state,并行回答 Choice、Score、Noul 问题;业务代码再按概率与风险决定执行、确认或升级。增速智谈原创教学示意。
一次调用里有两个核心输入:
• state:模型需要读取的状态,可以是文本,也可以是由文本字段组成的 JSON,例如客服对话、订单记录、当前页面元素或检索到的证据。
• questions:程序预先定义的判断问题,每个问题都限定输出类型和可选答案。
TypeSafe 公开了三种原语:[2][3]
Choice 从一组候选项中选一个,例如把工单路由到 billing / shipping / account;返回选中的项、每个候选项的概率,以及一个由分布计算出的 confidence。
Score 在有序等级上打分,例如把风险分成低、中、高,或按多个等级评估客户情绪;同样返回各等级概率和整体置信度。
Noul 来自 Bernoulli(伯努利)的缩写,本质是一个真假概率:例如“这段证据是否支持该结论?”输出一个 0 到 1 的值。Noul 本身不另带 confidence 字段,因为它的概率就是最直接的信号。[4]
从形式上看,Choice 可以写成:
p(cᵢ | state, question, criteria)
模型对候选集合中的每个 cᵢ 给出概率,默认决策是取概率最大的选项;真正是否执行,则由业务代码再应用阈值、权限和风险规则。
这一步很重要。Jev 并没有把“模型判断”直接等同于“系统动作”。它只是把以前藏在一段生成文本里的判断显式化,让代码可以看到完整分布,并决定:自动执行、请求用户确认、交给更强模型,还是升级给人。
Jev 真正提供的不是一个更聪明的 if,而是一个能把模糊语义压成可观测概率,再交回普通代码治理的判断函数。
02
“类型安全”解决的是输出形状,不是事实正确
TypeSafe 强调,Jev 不会输出未定义选项,也不会生成格式错误的 JSON。从类型系统的角度,这个保证是成立的:当答案空间只有 allow / block / review,模型不可能突然返回一段散文。
但这只能消灭一种错误:无效输出。它不能消灭另一种更危险的错误:在有效选项里选错。
如果一张橙子的照片被模型高置信地判成苹果,apple 当然仍然符合 schema。类型正确和语义正确是两条不同的轴。
TypeSafe 自己的文档已经明确承认,Jev 的校准描述的是一组预测,而不是某一次答案的保证。如果模型对一批事件都给出 0.8,那么理想状态下大约 80% 应该正确;这不意味着某个具体的 0.8 一定可靠。[2][6]
这就是“校准”与“准确率”的区别。
准确率问的是:一百道题答对了多少。校准问的是:模型报出的概率能不能对应真实发生频率。一个模型可能准确率很高,却总把 70% 报成 99%;也可能准确率略低,但知道哪些样本不确定。对于自动化系统,后者往往更有用,因为它允许系统只接管高置信部分,把剩余流量交给人或更强模型。
神经网络概率校准不是新问题。2017 年的经典研究已经指出,现代深度网络常常过度自信,简单的 temperature scaling 就能显著改善校准。[19] Jev 的新主张,是把校准从部署后的修补项提升为训练目标,并给这一路径命名为 Reinforcement Learning for Calibrated Decisions,简称 RLCD。[6]
但必须划清目前的证据边界:TypeSafe 尚未公开 RLCD 的算法、奖励构造、训练数据或消融实验,也没有发布 Jev 的参数量、底层架构和权重。官方说明了它“优化什么”,却没有说明具体“怎样做到”。在 Hacker News 的公开讨论中,TypeSafe CEO 也表示架构暂时不会披露,团队考虑未来写论文。[27]
因此,今天可以确认的是 Jev 的外部行为和接口契约:不做自回归文本生成、返回有限选项上的概率、多个问题可共享同一个 state 并行处理。至于它在模型内部究竟是新的 encoder、特制 decision head、经过 RLCD 后训练的预训练模型,还是多种已知方法的组合,目前都不能当作事实写死。
03
它不是从天而降,而是五条技术路线在 2026 年汇合
Jev 看起来新,是因为它以一个完整产品形态同时踩中了几条此前分散存在的路线。
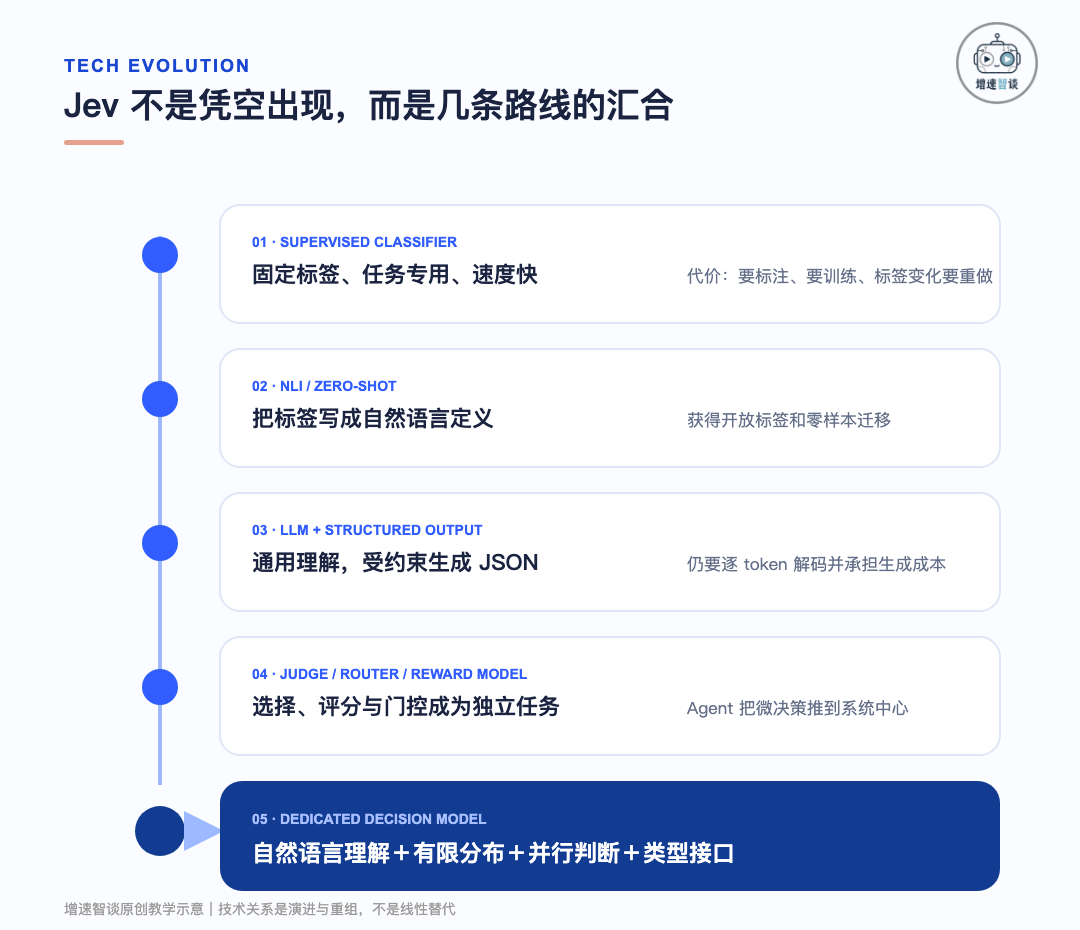
图 2:Jev 并非替代此前技术,而是在监督分类、零样本语义分类、结构化输出与模型路由之间重新划定产品边界。增速智谈原创教学示意。
第一条是监督分类器。
从逻辑回归、SVM 到 BERT 分类头,机器学习系统早就能把文本分到有限标签里。它们便宜、稳定、速度快,而且非常适合固定任务。问题是,传统分类器往往需要针对每个任务收集标注、训练和部署;一旦业务标签变了,模型就可能需要重训。
第二条是零样本文本分类与自然语言推断。
2019 年的研究已经系统地把零样本分类改写为 NLI:把输入当作 premise,把“这段文本属于体育”写成 hypothesis,再让模型判断蕴含关系。[18] 这让标签不再只是一个内部 ID,而可以用自然语言描述。后续工作进一步证明,给标签写好定义,本身就能明显提升零样本分类的准确率与鲁棒性。[20]
换句话说,“给任意标签写一段定义,让模型零样本分类”并不是 Jev 首创。
第三条是结构化输出与受约束解码。
LLM 时代,function calling、JSON schema 和 constrained decoding 让生成模型可以被限制在合法格式内。2025 年的 JSONSchemaBench 已经评估了 Guidance、Outlines、XGrammar、OpenAI、Gemini 等多种约束生成框架。[21] 它们解决了“输出必须可解析”的问题,却没有改变生成模型逐 token 解码的基本路径。
Jev 的区别在于,它根本不生成那串 JSON 文本,而是直接给出有限答案空间上的分布。前者是“让写作者严格填表”,后者更像“只保留判卷器”。
第四条是奖励模型、LLM-as-a-Judge 与路由器。
RLHF 里的 reward model,本质上就在比较候选回答;LLM-as-a-Judge 把生成模型当评委;RouteLLM 等研究则用轻量模型判断某个请求应该交给便宜模型还是强模型。[22] 这些工作共同证明,AI 系统内部有大量任务不是生成内容,而是选择、排序和门控。
第五条是Agent 系统的兴起。
当一个 AI 只是回答一次问题,生成成本还可以被看作单次体验的一部分。到了 Agent,模型需要连续选择工具、过滤记忆、判断风险、点击界面、验证结果。一项任务可能包含几十次甚至上百次微决策。如果每一步都调用最强 LLM,成本和延迟会沿着轨迹累积。
Jev 在 2026 年突然爆火,并不是因为分类技术刚刚出现,而是因为 Agent 把“每秒做很多次小判断”从幕后工程问题推到了前台。
Jev 的“新”,更像一次系统架构创新:把通用模型中的判断能力拆成独立服务,重新定义它的接口、计费、延迟和治理方式。
04
为什么是现在:AI 的单位正在从“回答”变成“决策”
TypeSafe 把模型命名为 Jev,来自经济学家 William Stanley Jevons。杰文斯悖论说的是:当一项资源的使用效率提高、单位成本下降,总消耗量反而可能上升。TypeSafe 的赌注也类似——当一次机器判断足够便宜,软件不会只把原有 LLM 调用换成更便宜的调用,而会在过去根本不值得用 AI 的地方增加成千上万次判断。[1]
这个叙事有很强的营销色彩,但底层经济逻辑是成立的。
一方面,Agent 的成本不只来自 token 数,还来自串行等待。生成式模型每一步都需要解码,如果下一步动作依赖上一步文本,延迟会不断累积。Jev 把多个针对同一 state 的问题放在一次请求里并行回答,适合那些彼此独立、答案空间有限的判断。[1][3]
另一方面,企业真正缺的往往不是再多一个聊天窗口,而是把 AI 放进既有软件流程。生产系统关心的是:输入是什么,输出有哪些类型,版本有没有变化,概率能否记录,阈值能否审计,错误能否回放。Jev 把这些要求直接写进接口。
截至 2026 年 9 月 29 日,官方公开的稳定版本是 jev-1.13.0。文档标价为每百万输入 token 0.042 美元,输出免费;单请求总预算 64K token,其中 state 加最长单个问题不超过 32K。模型只接受文本或由文本组成的结构化字段,不处理图片、音频和视频。英文是主要训练语言,中文等其他语言需要单独测试。[3]
TypeSafe 的官方 workflow eval 声称,在其选定任务上 Jev 可达到 193.6 倍速度和 444.6 倍成本优势;官方也主动注明,这套评测用最强外部模型的平均预测作为参考,而非任务真实标签,并且演示中的短而密集 state 对 Jev 有利。[1]
因此这些数字最多说明:在高度适配的封闭判断任务里,取消自回归输出可能带来数量级优势。它们不能被外推为“Jev 对所有 LLM 都快 200 倍”。
热度同样需要拆开看。据 VentureBeat 引述公司和平台数据,Jev 上线 36 小时内放行了约 14 万名等待用户,接入 Vercel AI Gateway 后 24 小时内约 13% 的付费团队使用过它;Cloudflare、LangChain、Langfuse 也迅速增加了集成。[24] 这些数字证明了开发者兴趣,却不等于大规模生产验证。
05
最近论文给出的答案:效率优势是真的,可靠性红线也很清楚
Jev 发布仅一周,arXiv 上已经出现一批直接研究。速度本身很罕见,但也意味着所有结果都还非常早期:它们是预印本,不是经过长期复现和同行评审的稳定共识。
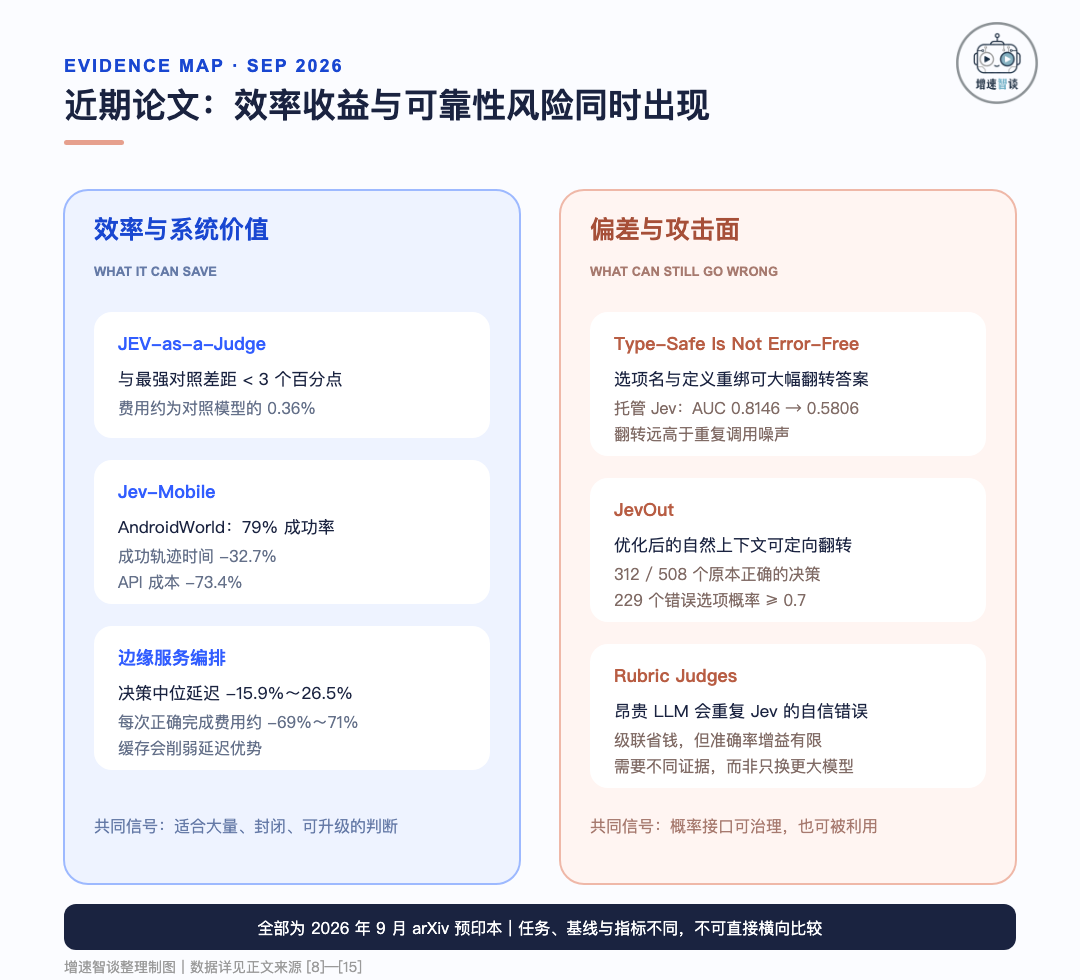
图 3:近期预印本同时给出效率收益和鲁棒性风险。不同论文任务、基线与指标不同,数字不能直接横向比较。增速智谈整理制图。
先看支持面。
作为低成本评审器。《JEV-as-a-Judge》把 Jev 与 16 个生成式和奖励模型评审器比较。在普通偏好判断和基于证据的事实性任务上,Jev 与最强对照模型相差不到 3 个百分点,费用只有对方的 0.36%;把低置信样本升级给更强模型的冻结级联,保留了对照模型 99% 的准确率。[8]
作为移动 Agent 的高频执行器。《Jev-Mobile》让 VLM 低频做规划,让 Jev 根据无障碍树高频选动作。在完整 AndroidWorld 任务上,Jev-Mobile 成功率为 79%,低于逐步 VLM 基线的 84%,但在成功轨迹中平均端到端时间降低 32.7%,API 成本降低 73.4%。[12]
作为边缘服务的意图入口。一项 6G/边缘服务编排实验显示,相比短结构化输出的 DeepSeek 部署,Jev 的客户端决策中位延迟下降 15.9%—26.5%;在双方都正确完成的请求上,端到端中位延迟下降 11.1%—25.3%,每次正确完成的 API 费用下降约 69%—71%。但论文也发现,一旦重复请求被缓存,延迟优势大幅消失。[13]
作为安全与对齐检测器。《Just Ask Jev》覆盖谄媚、越狱、欺骗、提示注入、幻觉等十类失败,在 44 个基准上使用通用问题获得 0.886 的中位 AUROC,并报告相对 LLM judge 约 63 倍的成本优势。更值得注意的是:问题措辞影响较小,输入 state 里有没有真正与标签相关的字段影响更大。[15]
这些结果共同支持一个有限但有价值的结论:当任务可以被压缩成共享上下文上的大量封闭判断,Jev 很可能是一个有效的第一阶段模型。
再看反证面。
类型安全不等于定义安全。《Type-Safe Is Not Error-Free》只改变选项名称与定义之间的绑定,就观察到显著翻转。在其 1200 个 workflow 决策设置中,把选项名从 0/1 改成 no/yes,每百个样本多改变 70.4 个答案,AUC 从 0.94 变到 0.23;在托管 Jev 上,交换也让 AUC 从 0.8146 降到 0.5806,并产生远高于重复调用噪声的翻转。[9]
自然上下文可以诱导高置信错误。《JevOut》从 Jev 原本答对的 508 个决策出发,在不改题目、选项和正确答案的前提下,加入自然且看似相关的背景句。经过最多 64 次目标评估,312 个决策被定向翻到预设错误选项,翻转率 61.4%;其中 229 个错误选项最终获得至少 0.7 的概率。[14] 这是一种带优化预算的攻击结果,不代表随便加一句话就有六成翻转,但它说明概率接口本身也会成为攻击面。
提示注入会移动概率,但不必然接管动作。《Decision Hijacking》在 510 个直接伤害场景上发现,原始攻击的目标动作选择率为 1.8%;经过 24 轮确定性优化并用新调用复验后,验证攻击成功率升至 3.5%,置信度不低于 0.7 的目标动作仍只占 0.2%。最危险的主要是本来就靠近决策边界的样本。[17] 这项结果和 JevOut 并不矛盾:前者测常见注入能否把 Agent 推到恶意动作,后者主动搜索能翻转分类的上下文。两者共同提醒我们,不能把“概率被影响”和“动作被劫持”写成同一件事。
便宜模型与昂贵模型可能错在同一个地方。Rao 与 Callison-Burch 的研究发现,在九组 rubric judge 面板上,LLM 每项准则单独调用时的总成本是 Jev 的 29—325 倍,耗时是 30—220 倍;但更强 LLM 往往会重复 Jev 最自信的错误。于是“Jev 先筛,LLM 兜底”虽然省钱,却最多只带来有限的准确率提升。[11]
总分相近,不代表个体决策稳定。法律文档研究显示,Jev 在被测配置里成本和中位延迟最低,但托管 LLM 的基线准确率更高;改变假设可见性、输出顺序或请求配置后,模型排名和个体判断会变化。[10]
把正反两面合起来,真正稳妥的结论不是“Jev 可靠”或“Jev 不可靠”,而是:它把判断成本降了下来,也把判断接口暴露得更清楚;这既方便治理,也让我们更容易看见模型原本就有的偏差、注入和分布漂移。
06
最适合的四类应用,以及不该交给它的事
第一类:高频路由与分类
客服工单分流、内容标签、销售线索分级、邮件意图识别、模型选择、工具选择,都是 Jev 最自然的场景。它们有明确答案空间,错误通常可以通过置信度门槛、重试或人工复核控制。
相较固定分类器,Jev 的优势是标签和定义可以随请求改变,不必为每套标签重新训练;相较通用 LLM,优势是没有文本生成和解析层。
但如果标签长期稳定、训练数据充足、吞吐量巨大,一个针对任务训练的 BERT、ModernBERT 或更小分类器往往仍然更便宜、更可控。开发者自测也普遍指向同一边界:Jev 最有价值的时刻,是没有标注、需要今天上线,或者标签经常变化。[28]
第二类:Agent 的低层执行与状态判断
规划模型可以先给出局部目标,例如“打开设置并关闭通知”;Jev 再对每一屏的可执行元素做选择。它也可以判断哪段记忆值得保留、哪个工具符合当前意图、某个动作是否需要确认。
这类架构不是让 Jev 代替推理,而是把 Agent 拆成两种节奏:慢模型负责计划、处理新情况和解释,快模型负责重复、局部、可枚举的动作。Jev-Mobile 的结果正是这个方向的早期证据。[12]
最近刷屏的 Pokémon Red 演示也说明了同一件事。Jev 最终在 9 月 23 日击败四天王和冠军,但它不是独立读屏、独立规划:Opus 5 持续监控游戏日志并实时修改 Jev 可见的状态、选项和 harness,项目累计记录了 474 次 harness 变更。[29][30] 它证明专用决策模型可以低成本运行在长轨迹里,也证明演示成败往往属于整个系统,而不能只归功于一个模型。
第三类:评测、安全与内容门控
当平台需要对每条生成内容检查几十项 rubric,逐项调用 LLM 会很昂贵。Jev 可以一次并行回答“是否有事实支持”“是否泄露隐私”“是否需要人工复核”等多个问题,再把不确定或高风险样本升级。
但安全门控必须假设输入是敌对的。TypeSafe 自己的 jaggedness 文档明确提醒:Jev 1.13 不会默认把 state 当成敌对内容,提示注入、误导性框架和自我辩护文本都可能移动答案。[5]
第四类:检索、排序与数据整理
在 RAG 系统里,它可以判断检索段落是否相关、某个引文是否支持结论、候选实体是否匹配,或从已有候选值中选出正确字段。TypeSafe 官方 cookbook 已展示法律检索重排、引用检查、层级分类、预解析值抽取等模式。[2]
它不适合做的事情同样清楚。
需要写作、总结、翻译、代码生成和开放式解释时,应该用生成模型;需要精确数学、计数、日期比较和权限校验时,应该用普通代码;需要多跳推理、复杂因果分析或处理大量无关长上下文时,Jev 1.13 的官方文档已经承认能力会明显下降。[5]
一个简单判断标准:如果输出可以提前枚举,错误可以被门控,且这个判断会被高频重复,Jev 值得测试;如果答案本身必须被创造、证明或解释,它就不是主角。
07
真正的生产架构,不是“让 Jev 接管”,而是让它学会退出
一个可靠的 Jev 系统,不应该是 state → Jev → 执行动作 的直线。它更像一个有多个出口的决策级联。
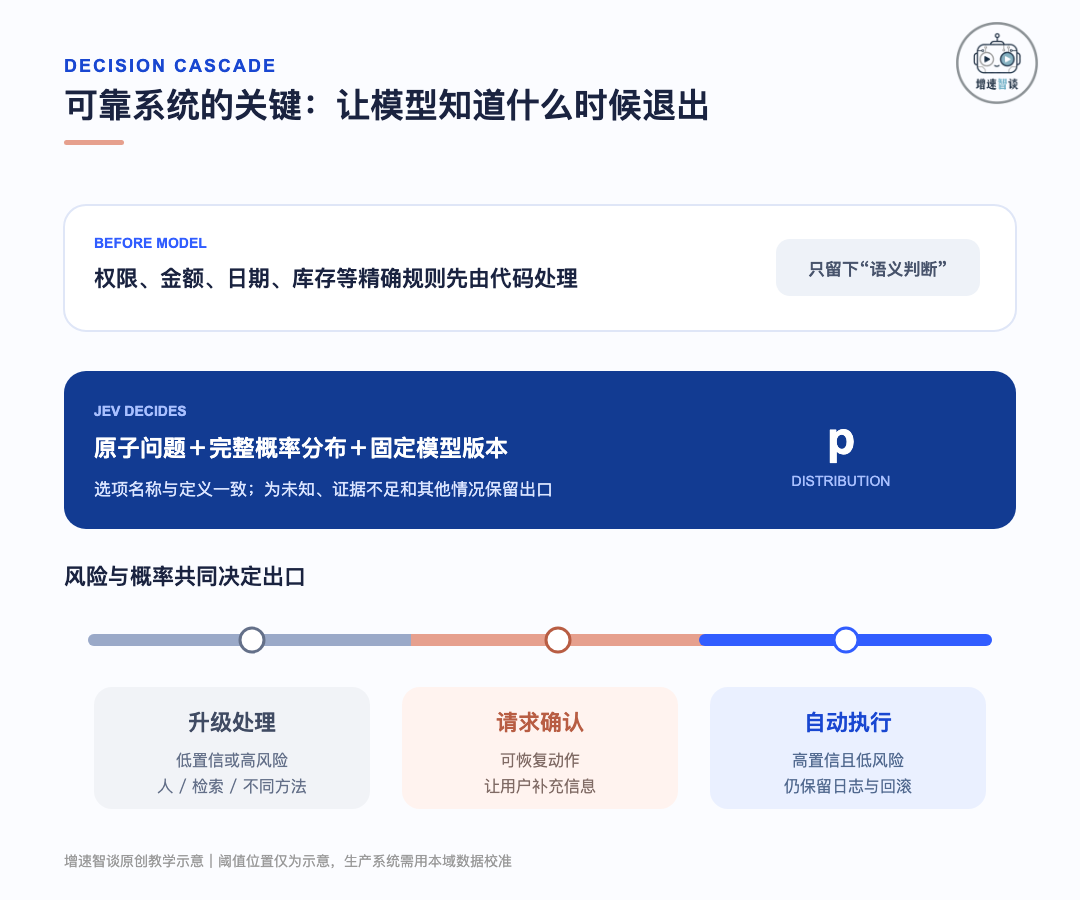
图 4:高置信并不自动等于可执行。生产阈值要同时考虑模型概率、动作风险、确定性规则与人工复核成本。图中阈值仅为示意。
第一层是确定性预处理:权限、金额、库存、日期、正则匹配等能用代码解决的事情,不交给模型。
第二层是状态构造:只把完成判断真正需要的字段交给模型。长而杂乱的上下文不仅浪费 token,也会增加干扰和注入面。
第三层才是 Jev 的原子判断:每个问题只做一件事,选项名称与定义保持语义一致,并显式提供 other / unknown / insufficient_evidence 等退出选项。
第四层是风险门控:相同置信度下,打开一个页面和转出一笔钱显然不是同一个阈值。低风险动作可以自动执行;中风险要求用户确认;高风险即使模型很自信,也应叠加规则校验或人工批准。
第五层是升级路径:低置信样本可以交给更强 LLM、检索系统或人。但升级模型必须使用不同证据或不同方法,否则就会出现论文揭示的“昂贵模型与便宜模型错在同一处”。[11]
第六层是持续评测:固定模型版本,记录 state、问题、选项顺序、完整概率、阈值、最终动作和人工结果。jev-latest 会随版本移动;如果生产阈值是针对某个版本校准的,应固定到 jev-1.13.0 之类的版本 ID,再主动迁移。[3]
评测也不能只看准确率。至少要同时跟踪六组指标:
• 任务质量:accuracy、F1、AUROC,按类别和业务分层统计。
• 概率质量:Brier score、NLL、ECE 与可靠性图,检查 0.8 是否真的接近八成正确。
• 风险—覆盖率:阈值提高后,自动处理比例下降多少,错误率是否按预期下降。
• 稳定性:改写问题、交换选项顺序、替换等义标签、增加无关背景后,答案翻转多少。
• 安全性:提示注入、恶意自我描述、冲突字段和长上下文下是否出现高置信错误。
• 系统经济性:端到端延迟、每个正确决策成本、升级率和人工复核成本,而不是只比较 API 单价。
校准尤其不能照搬全局数字。一个模型在英文客服邮件上校准良好,不代表它在中文合同、金融风险或新出现的攻击文本上仍然可靠。业务方必须用自己的时间切分数据做阈值选择,并定期检查分布漂移。
08
“新范式”还是“高级分类器”?这个问题本身问偏了
如果只看学术谱系,Jev 很难被称为凭空出现的新范式。有限标签分类、NLI 零样本分类、概率校准、奖励模型、受约束输出和模型路由都已有多年研究。开源社区也已经迅速出现利用现有开放模型 logits 构造 Jev 式接口的项目,说明“只输出决策”不一定依赖唯一架构。
如果只看产品形态,它又确实做了一件过去没有被主流基础模型公司优先做的事:放弃“什么都能生成”,把模型的全部能力、API、评测和定价围绕软件判断重新设计。
这就像数据库并没有发明“保存数据”,却把数据存取变成了可依赖的系统原语。Jev 是否能成为类似的基础设施,取决于三个尚未回答的问题。
第一,校准能否跨领域、跨语言、跨版本保持。如果每个客户仍然需要大量标注数据重做温度缩放和阈值选择,它相对定制分类器的优势会缩小。
第二,独立模型能否追平或超过 Jev 的质量—成本曲线。TypeSafe 目前的架构和数据是黑箱;当开源模型通过 logit scoring、位置校正和轻量微调得到类似接口,护城河可能更多来自数据、服务和生态,而非“System One”这个类别名称。
第三,Agent 的软件栈是否真的会把规划与执行分层。如果未来通用模型的推理成本持续下降、结构化输出变得足够快,独立决策模型的空间会被压缩;如果 Agent 走向高频后台自动化,专用判断层的价值反而会放大。
因此,Jev 眼下最值得重视的不是“模型是不是革命”,而是它提出了一个非常实用的问题:
我们为什么要让一个擅长写作和推理的通用模型,承担软件里每一个微小的真假判断?
09
结语:AI 不一定要说话,才算在工作
过去几年,公众理解 AI 的主要方式是一只对话框。模型是否聪明,往往通过它写了什么、解释得多像人来判断。
Jev 把镜头移到了对话框背后:大量真正驱动软件运行的智能,不是长回答,而是路由、过滤、排序、允许、拒绝、升级和选择下一步。
它的技术并非没有前史,它的性能也远未被充分验证。TypeSafe 没有公开架构与 RLCD 细节,近期论文仍是预印本,选项偏差、上下文攻击、语言差异和高置信错误都是真实风险。
但 Jev 仍然可能成为 2026 年最值得关注的 AI 产品之一。原因不是它比大模型“更像人”,恰恰是它主动放弃了像人一样回答,开始像软件组件一样工作。
Jev 的真正信号是:生成模型之后,AI 基础设施的下一场竞争,可能不再只是谁能写出更好的答案,而是谁能把一次判断做得足够便宜、足够可观测,也足够知道什么时候不该自己做主。
参考来源
• [1] TypeSafe AI:Introducing System One Models & Jev
• [2] TypeSafe 文档:System One
• [3] TypeSafe 文档:Models
• [4] TypeSafe 文档:Confidence
• [5] TypeSafe 文档:Jev 1.13 jaggedness
• [6] TypeSafe 文档:AI primer / RLCD
• [7] DCVC:TypeSafe emerges from stealth with a new way of doing AI
• [8] JEV-as-a-Judge: Accept When Confident, Escalate When Unsure
• [9] Type-Safe Is Not Error-Free
• [10] Same Scores, Different Decisions
• [11] JEV vs. LLMs as Rubric Judges
• [12] Jev-Mobile: Jev as an Executor for Mobile GUI Agents
• [13] Replacing Large Language Models with Jev Decision Models for Low-Latency Edge Service Orchestration
• [14] JevOut: Natural Context Can Flip Decision Models
• [15] Just Ask Jev
• [16] Jev in the Wild
• [17] Decision Hijacking: Prompt Injection Attacks on Jev's Typed Probabilistic Decisions
• [18] Benchmarking Zero-shot Text Classification
• [19] On Calibration of Modern Neural Networks
• [20] The Benefits of Label-Description Training for Zero-Shot Text Classification
• [21] Generating Structured Outputs from Language Models: Benchmark and Studies
• [22] RouteLLM: Learning to Route LLMs with Preference Data
• [23] Unveiling Selection Biases: Exploring Order and Token Sensitivity in Large Language Models
• [24] VentureBeat:Companies are putting Jev in charge of AI agent decisions
• [25] ITmedia AI+:文章を書かない AI がなぜ話題に?
• [26] The Next Web:The fastest-adopted model on Vercel this year cannot write a word
• [27] Hacker News:Introducing System One Models and Jev
• [28] Reddit 开发者自测:JEV vs. LLMs, BERT and Laya
• [29] Standard Agents:Jev plays Pokémon Red
• [30] Tom's Hardware:Jev beat Pokémon Red with Opus 5 coaching the harness